[제07장] 로고송과 배경음악을 목적에 맞게 생성하기: 15초 CM송, 보컬 없는 BGM 연출과 타이밍 정밀화
07장. 로고송과 배경음악을 목적에 맞게 생성하기
**이 장의 목표**
- 실용 음악(광고 로고송, CM송, 영상/게임 BGM)의 엄격한 시간 규격과 제작 요구서를 이해한다.
- 15초/30초 타임 리미트를 지닌 P03 〈숲소리 다방〉 로고송 실전 초안을 생성한다.
- 무한 반복(Seamless Loop)이 가능한 P04 〈고요한 항해〉 연주곡 BGM 초안을 제작한다.
---
07.1 이름과 메시지가 남는 짧은 가사
일반 가요가 감정과 서사를 길게 풀어내는 예술이라면, 로고송과 CM송은 15초 또는 30초라는 극도로 제한된 시간 안에 브랜드 이름과 핵심 가치를 청자의 뇌리에 각인시키는 상업 예술입니다.
따라서 가사를 쓸 때 군더더기 형용사를 모두 배제하고, 1) 브랜드명, 2) 브랜드가 주는 핵심 효익(Benefit), 3) 경쾌한 행동 유도(Call to Action)만을 압축해야 합니다.
[실전 프로젝트 P03 제작 요구서: 가상 브랜드 '숲소리 다방']
- 목적: 친환경 원두와 자연의 휴식을 테마로 하는 카페 브랜드 로고송.
- 방송 규격 목표: 15초 TV/라디오 스팟 광고용 버전 및 30초 온라인 바이럴 버전.
- 핵심 훅(Hook): "자연을 담은 한 잔, 숲소리 다방"
- 필수 악기: 기분 좋은 어쿠스틱 기타 스트로밍, 가벼운 휘파람, 맑고 또렷한 여성 보컬.
한편 영상이나 게임에 쓰이는 배경음악(BGM)은 사람의 목소리가 성우의 내레이션이나 게임 대사를 가리지 않아야 하므로, 반드시 Instrumental(보컬 없는 순수 연주곡) 모드로 기획해야 합니다.
[그림 07-1] 브랜드명과 정확한 시간 규격을 정의한 P03/P04 실용 음악 기획서 양식.
---
07.2 로고송과 CM송의 초안 만들기
수노에서 P03 로고송을 생성할 때는 가사의 줄 수를 2~4줄 이내로 매우 짧게 제한해야 합니다.
[Lyrics 입력값: P03 숲소리 다방 (15초 초안)]
[Intro - Upbeat whistle]
바쁜 하루 끝에 만나는 작은 숲
향긋한 커피 한 잔의 쉼표
자연을 담은 숲소리 다방!
[Outro - Acoustic chord finish]
스타일 프롬프트에는 Bright acoustic commercial jingle, happy whistle melody, clear female commercial voice, crisp acoustic guitar, 115 BPM을 지정합니다.
생성 결과, 수노는 다음과 같은 후보들을 출력했습니다:
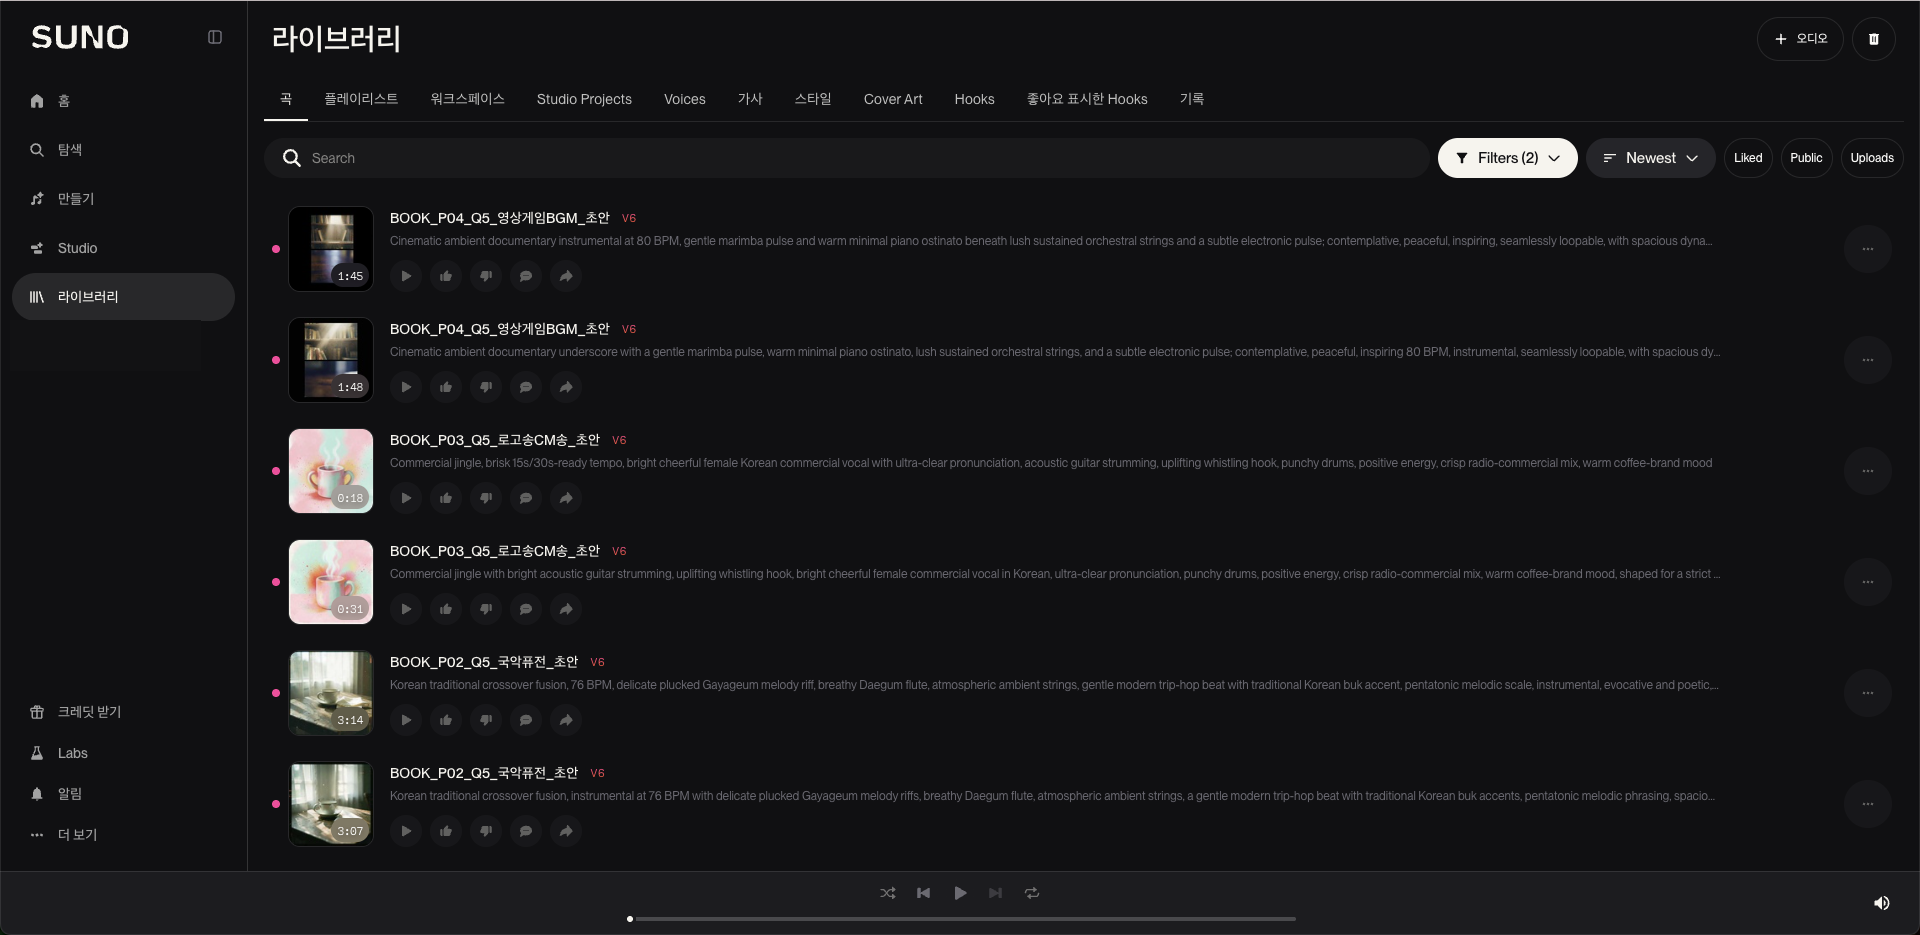
[그림 07-2] 18.4초와 31.2초로 생성된 로고송 후보 목록. 규격 시간보다 약간 길게 생성된 것이 정상이다.
스마트폰으로 QR 코드를 스캔하면 독자 자료실에서 P03 로고송 〈숲소리 다방〉 15초 원석 음원(18.4초)을 바로 청취 및 다운로드할 수 있습니다.
---
07.3 대사와 장면을 위한 BGM 초안
네 번째 대표 프로젝트인 P04 영상·게임 BGM 〈고요한 항해〉를 제작합니다. 이 곡의 핵심은 "내레이션을 방해하지 않는 절제된 사운드스케이프"와 "무한 반복 재생(Loop)의 용이성"입니다.
1. 수노 생성 창에서 [Instrumental] 토글을 켜서 보컬을 원천 차단합니다.
2. 스타일 프롬프트에 다음과 같이 입력합니다:
Ambient documentary background music, minimal marimba pulse, warm piano ostinato, gentle sustained string orchestra, cinematic, inspiring, seamless loop feel, 80 BPM
3. 생성된 음원:
[그림 07-3] 보컬 없이 일정한 템포와 몽환적 공간감을 유지하도록 생성된 P04 연주곡 파형.
스마트폰으로 QR 코드를 스캔하면 독자 자료실에서 P04 다큐멘터리 BGM 〈고요한 항해〉 루프 음원(104.76초)을 바로 청취 및 다운로드할 수 있습니다.
---
07.4 길이와 허밍 및 고유명사 문제 찾기
많은 초보자가 "수노에 15초라고 적었는데 왜 18.4초가 나왔나요?"라며 당황합니다.
**[기술적 사실] AI 모델의 시간 인식 한계**
거대 생성 오디오 모델은 초 단위의 물리적 시계를 보며 음악을 만드는 것이 아니라, 음악적 마디와 프레이즈의 흐름에 따라 오디오 토큰을 생성합니다. 따라서 프롬프트에 `exact 15 seconds`라고 아무리 적어도 AI가 1프레임의 오차도 없이 15.00초에 음악을 딱 끝내는 것은 불가능합니다.
또한 로고송의 끝부분에 불필요한 '음~' 하는 허밍이 붙거나, 고유명사(예: '숲소리 다방'이 '숲소리 다팡'으로 들림)가 살짝 뭉개지는 현상이 흔히 발생합니다.
이것은 실패가 아니라 자연스러운 현상입니다. 우리는 18.4초짜리 원석에서 불필요한 앞뒤 여백 3.4초를 10장 Studio 타임라인에서 칼같이 잘라내어 정확히 15.00초로 맞추고, 끝 음에 리버브 잔향 페이드아웃을 적용할 것입니다. 이것이 바로 생성과 DAW 편집이 결합하는 지점입니다.
[그림 07-4] 18.4초 음원에서 정확히 15.00초를 분할하기 위한 타임라인 컷팅 계획도.
---


